IEEE ICONET26
MelodicVision (Melvis)
مصنّف الأنواع الموسيقية بالذكاء الاصطناعي، عُرض في مؤتمر IEEE
PyTorchResNet-18librosaGrad-CAMTransfer learning
المشكلة
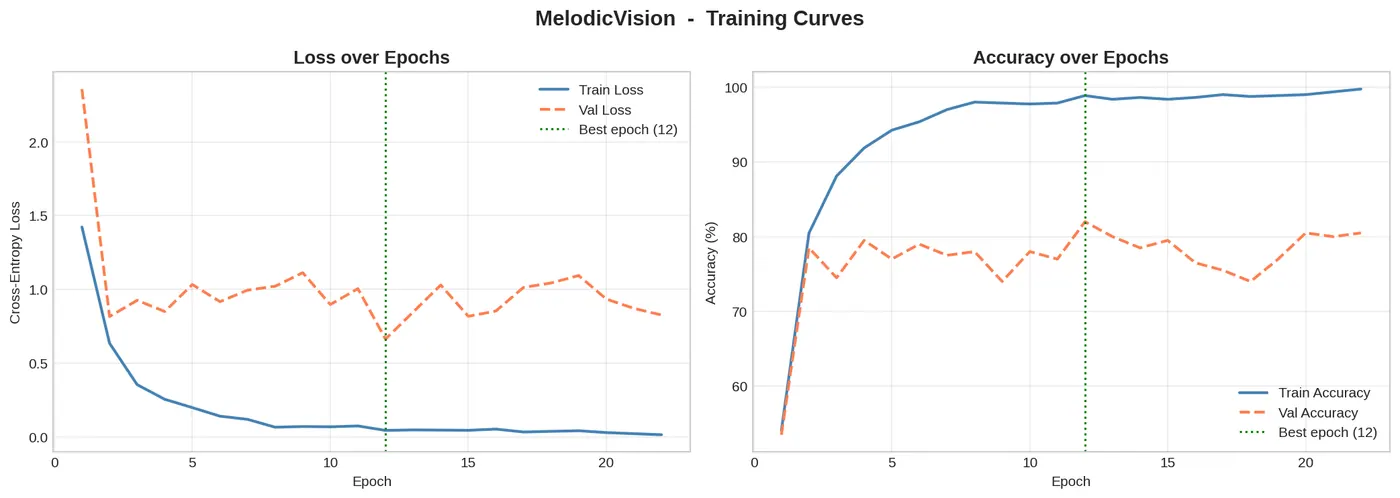
مجموعة GTZAN صغيرة جداً (799 مقطعاً للتدريب). تدريب نموذج صوتي من الصفر يؤدي إلى الإفراط في الملاءمة؛ السؤال كان: هل يمكن لنموذج رؤية أن ينقل ما تعلّمه عن الحواف والأنسجة إلى الصوت؟
ما بُني
- خط معالجة من الصوت إلى مخططات Mel عبر librosa؛ ضبط ResNet-18 بمعدلات تعلّم متدرّجة بحيث تحتفظ الطبقات الأولى بمعرفتها من ImageNet.
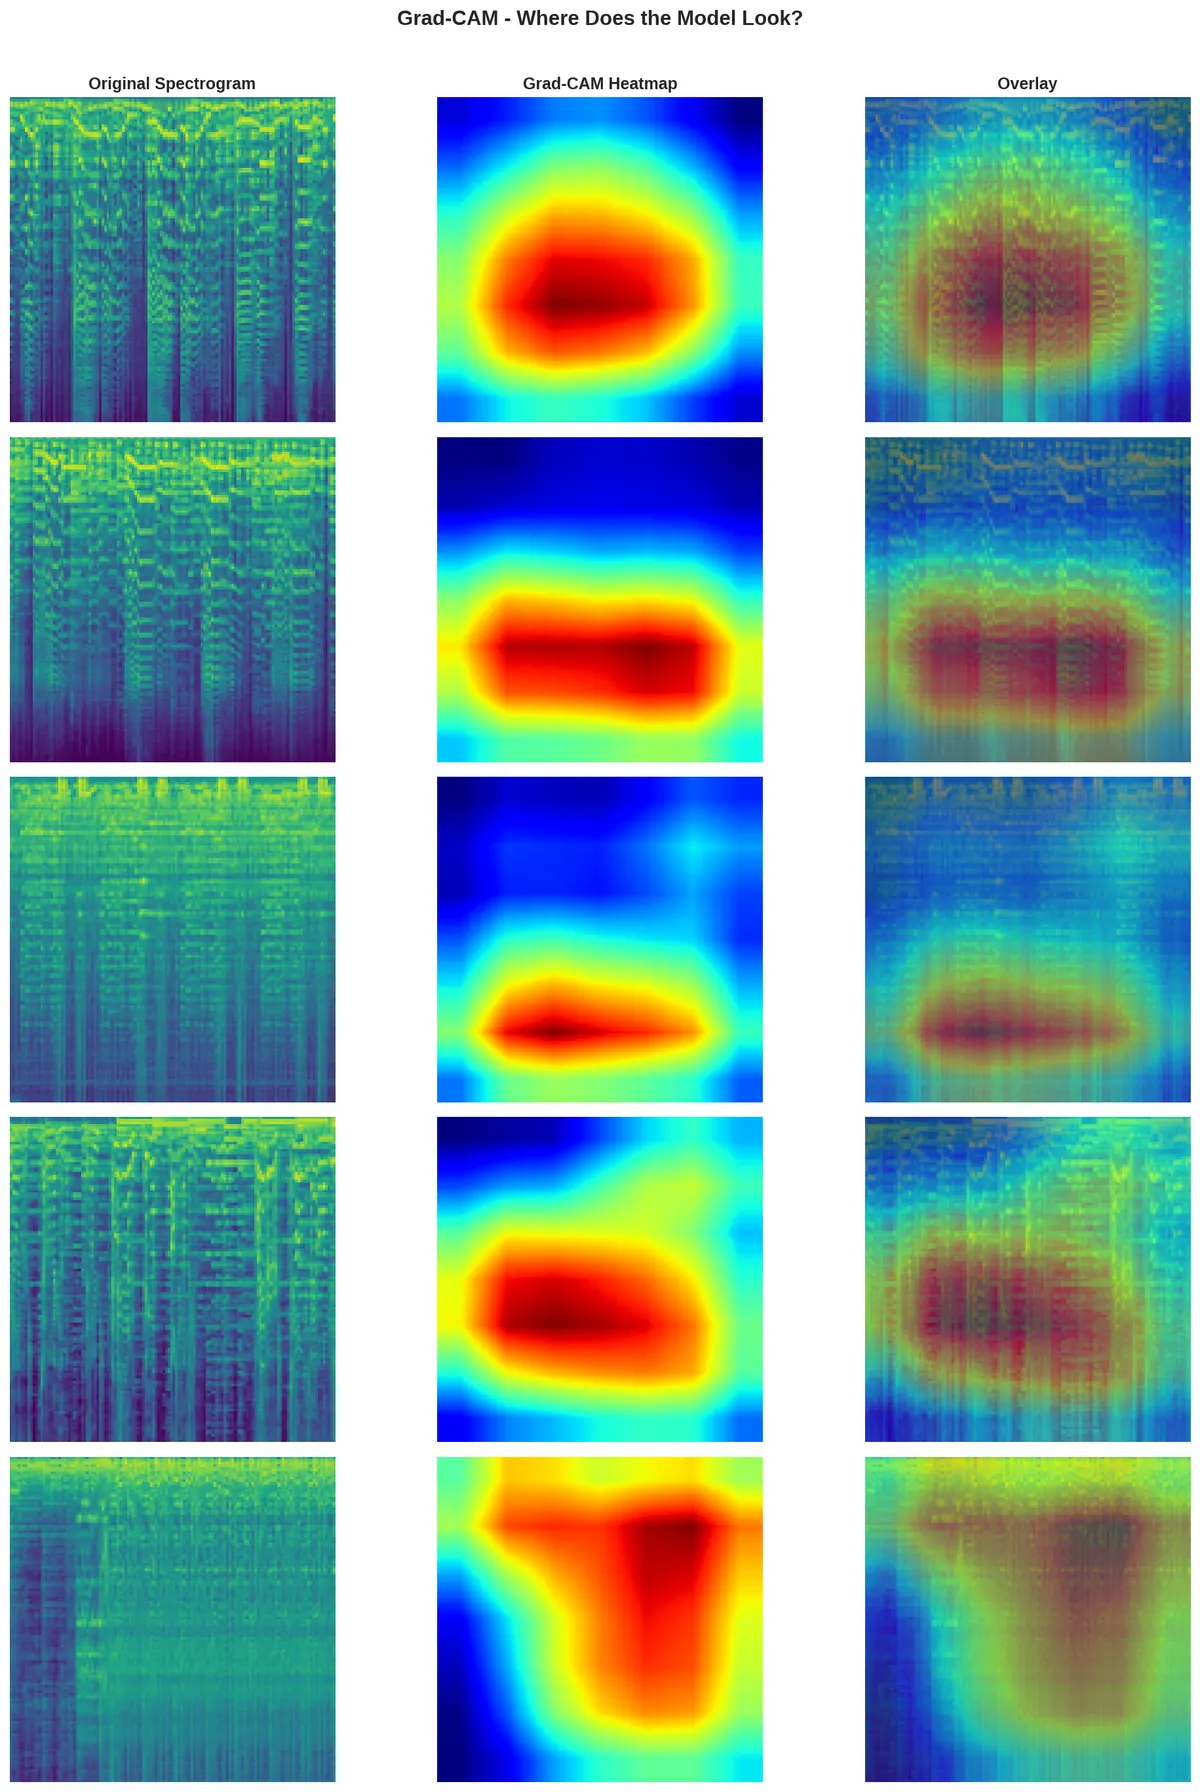
- تفسير بـ Grad-CAM: يركّز النموذج على النطاقات المتوسطة الغنية توافقياً للكلاسيك والجاز، وعلى الطاقة العريضة للميتال.
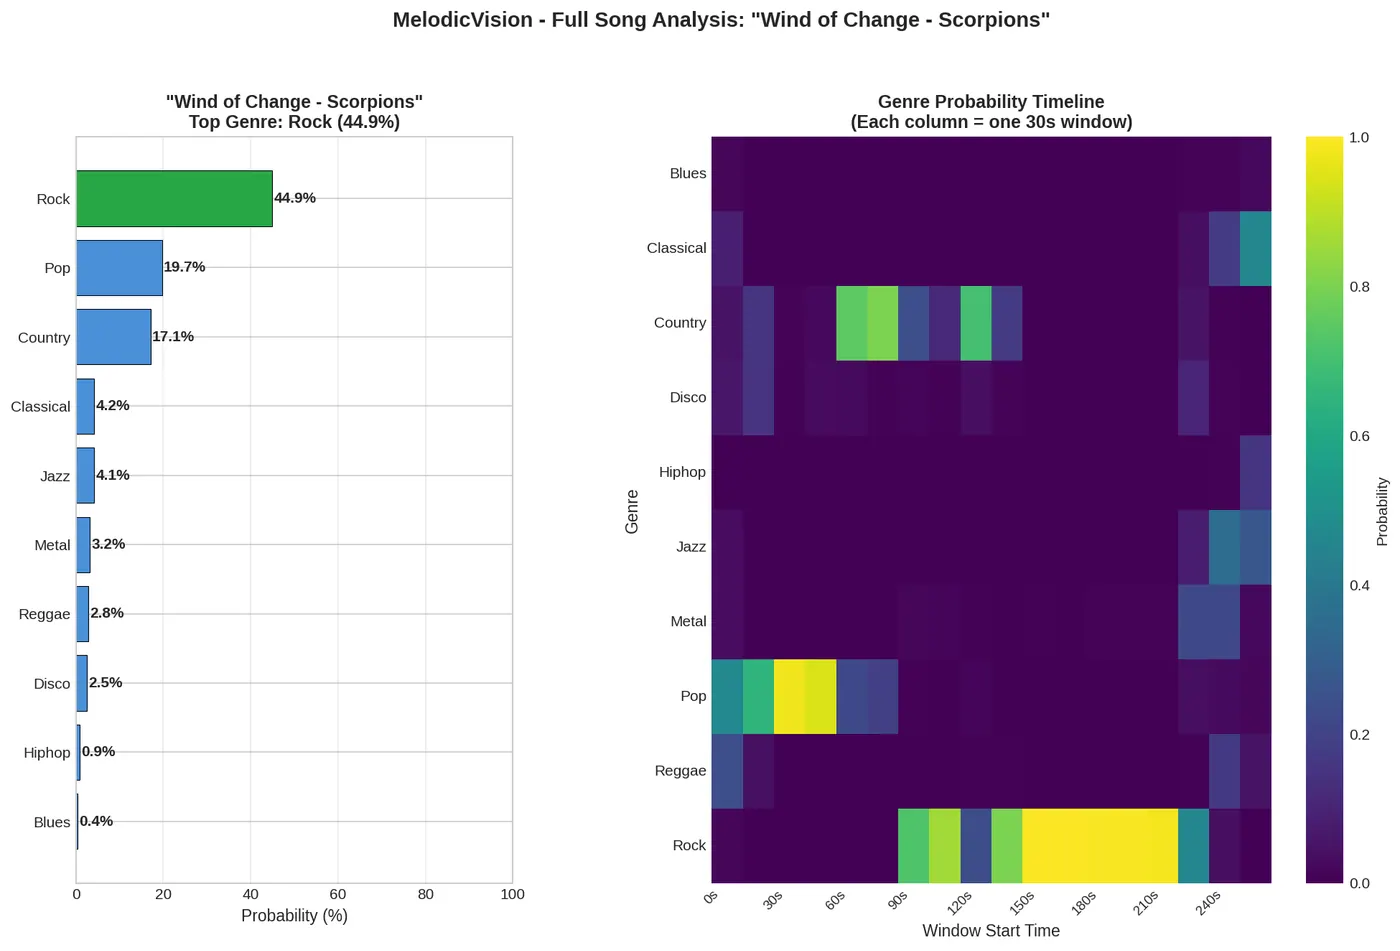
- تجميع بنافذة منزلقة لتصنيف الأغاني الكاملة بأي مدة، لا المقاطع القصيرة فقط.
النتيجة
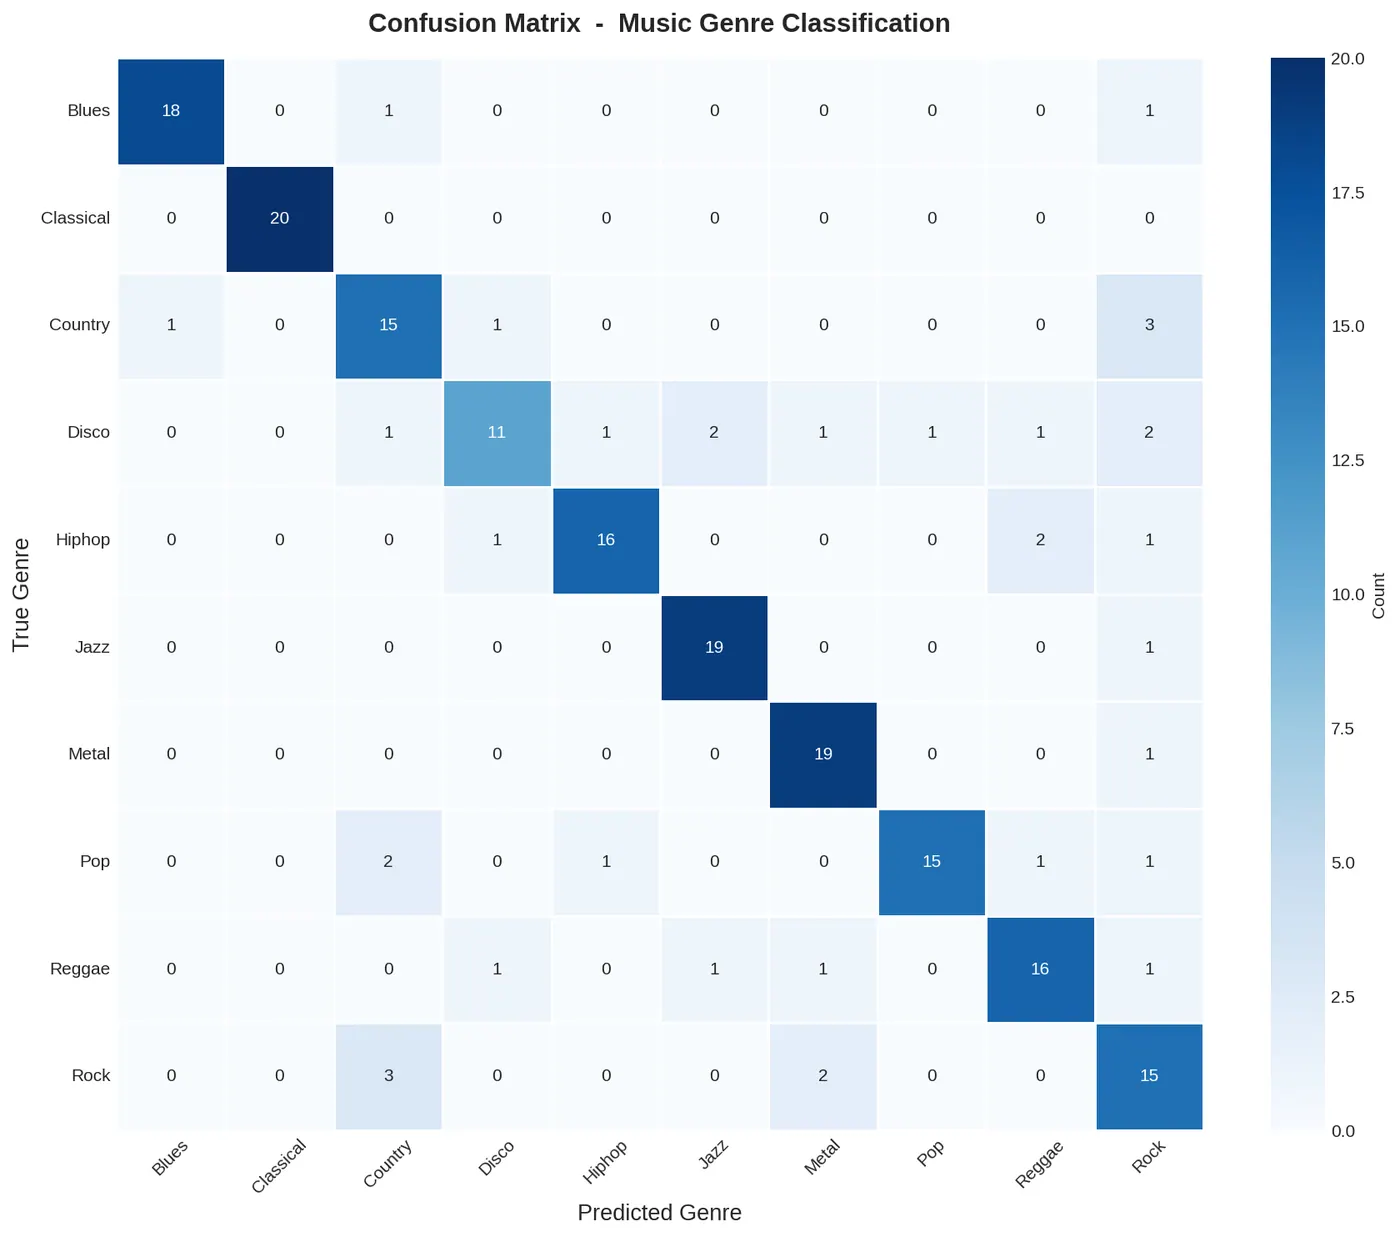
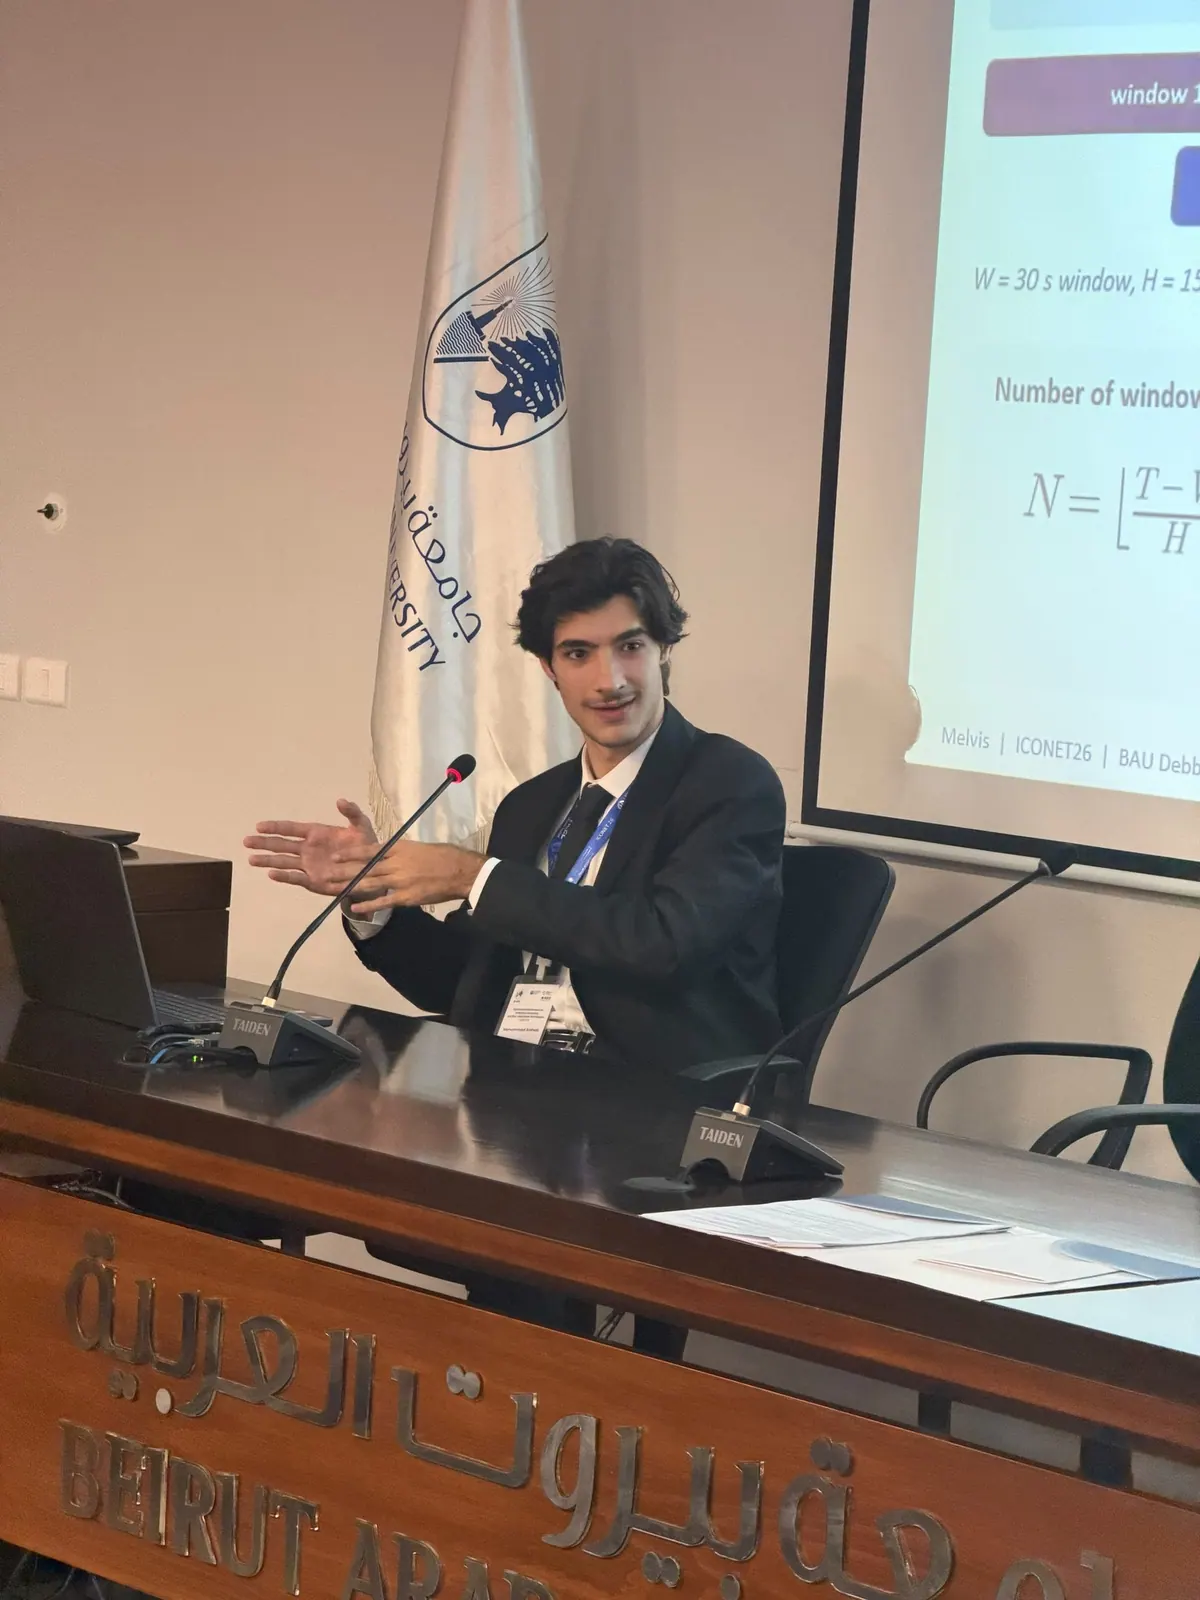
دقة 82% على الاختبار بـ 799 مقطعاً للتدريب فقط. قُبل البحث وعُرض في ICONET26 (فرع لبنان لجمعية IEEE للحاسوب)، بالاشتراك مع د. زياد دوغان.
اسمع ما يراه النموذج
يحوّل MelodicVision الصوت إلى مخطط طيفي Mel ويقرأه كصورة. استخدم الميكروفون، أو شغّل لحناً مولّداً، وشاهد المخطط يُرسم مباشرة.
عالٍمتوسطمنخفض
Mel · 64 نطاقاً · مباشر
يعمل في متصفحك فقط؛ لا يُسجَّل شيء ولا يُرفع.
صور